去年有个做户外家具的客户来找我们,说他们投入不小的电商Web3D展示上线之后,客服接到了奇怪的反馈:产品页要等很久才能动,有的客户以为网站坏了,直接关掉了。我们拿手机 4G 实测,从点击到模型能转起来,八秒三。
八秒。
这个数字放在电商里基本就是劝退。
问题不在服务器,也不在 CDN,就在模型本身。
我们把那个 GLB 拆开看,单个户外沙发 38MB。贴图吃掉 31MB,里面多半是 4K 的 PBR 三件套,基础色、粗糙度、金属度各一张,还夹着一张根本没派上用场的 AO 图。几何体 6MB,包含几十颗肉眼看不见的螺丝、内部支撑框架,以及被坐垫完全挡住的骨架结构。
客户听到 38MB 的反应是「我们设计师导出的时候就是这么大」。
这句话我听过太多次,它说明的不是设计师水平不行,是游戏引擎和电商网页对模型的要求压根不是一回事。游戏可以预加载几百兆资源、可以要求玩家装客户端,浏览器不行,客户在手机上,可能正站在地铁里用四格信号。
一个真实对比:同样展示一把椅子,用 800px 宽的 WebP 照片是 50KB,用一段 15 秒的产品视频是 5MB,用一个没优化过的 GLB 是 38MB。三种形式在客户页面上承担的是同一件事,体积差 760 倍。
38MB 里到底装了些什么
顺序拆开就很清楚。贴图是大头,通常占七成以上,而七成里面又有一半是分辨率过剩。一把椅子在手机屏幕上最多显示到 800px 宽,你却给了它 4096×4096 的贴图,多出来的 96% 像素永远不会被看到。剩下的几何体里,真正的可见部分往往只有原模型的四分之一,其余是建模时为了「完整」而保留的内部结构、螺纹细节、背面的卡扣。
还有一种更隐蔽的浪费:同一个沙发系列有六种面料,设计师导出了六个完整的 GLB,每个都是独立的 30MB。六款加起来 180MB,而其中 90% 的几何体完全相同。
能砍的几刀,按收益排序
几何压缩是回报最高的一刀。Draco 是谷歌开源的几何压缩方案,对顶点、法线、UV 做量化和熵编码,配合 three.js 的 DRACOLoader 直接解码。同一把椅子,几何体从 6MB 压到 400KB 出头。
压掉 93%,视觉上看不出区别,因为被压掉的是浮点数里的精度冗余,不是形状信息。
贴图这一刀收益更大。走 KTX2 + Basis Universal,GPU 直接读压缩纹理,不用先解码成位图再上传显存,贴图体积能降到原来的五分之一到十分之一。
如果暂时不上 KTX2,至少把 4K 降到 1K 或 2K,把 AO 图删掉(大多数电商展示用不上,有环境光贴图就够),把三张 PBR 图合并成 ORM 通道打包。这一步通常能省下 60% 到 80% 的贴图体积。
删内部结构听起来粗暴,但这是建模规范问题。做电商展示用的模型,从一开始就该只建客户看得到的部分,内部用简单的封闭面代替。我们做家具3D选装配置器项目时,会在建模规范里明确写「不可见面不建模、螺丝孔用贴图表现」,这一条能省下 20% 到 30% 的面数。
LOD 分级是给移动端准备的。同一个产品出高、中、低三档模型,桌面端加载高模,手机加载中模,检测到设备性能差就上低模。低模可以只有两万面,远看几乎无差别。用户拖动旋转满足基本体验,停下两秒再偷偷换成高模。
体积达标了还是慢?问题出在加载顺序
这是很多人漏掉的一层。模型压到 1.5MB,页面打开依然卡,因为主线程被阻塞了。3D 库在解析模型的时候,同时在建场景、算光照、初始化控制器,浏览器的渲染主线程被占满,用户点什么都没反应。
解法是把第一帧交出去。进入产品页先显示一张静态的封面图(poster),这张图就是模型转到一个好看角度的渲染,二十几 KB。用户看到的是「产品已经在那儿了」,同时后台静默加载真模型。等加载完,用交叉淡入把静态图换成可交互的 3D,用户几乎察觉不到切换。
再往细一层,是别让 3D 库进首屏关键路径。three.js 完整包两百多 KB,实际用到的功能可能只有一小半,按需引入能砍到八十 KB 以内,并且用动态 import 推迟到用户真的要交互时再加载。页面先能看、先能滚动、先能把产品加进购物车,3D 是锦上添花的那一层,它不该挡在任何东西前面。
什么程度算达标
给几个我们自己用的数字,不是行业标准,但照着做基本不会出问题:
初始加载的模型加贴图总量控制在 2MB 以内,这是硬线。手游玩家容忍度更高,电商客户没有耐心。中端安卓机(我们测试用红米系列)上,从进入页面到模型可交互,三秒内算合格,两秒内算好。交互过程中帧率稳定在 50 帧以上,低于 40 帧用户能感觉到拖沓。首屏到可滚动的时间不受 3D 影响,这才是真正的体验底线。
顺便说一句,做性能预算这件事本身比任何单个技巧都重要。我们做 3D产品交互的规划方法时会把预算写进合同附件:模型总量多少、首帧多久、低端机降级方案是什么。写进去之后,后面所有环节都有依据,不会出现「做完了才发现手机上跑不动」这种返工。
一个容易忽略的顺序问题
很多项目是先把 3D 做完,再想怎么嵌进页面,结果模型做得很精细,网页那边接不上,只能回头重新减面压缩,等于做两遍。
正确的顺序反过来:先确定这个产品页要在什么设备上跑、能容忍多大体积、客户最想看的三个角度是什么,然后再决定模型怎么做。这套逻辑在 3D产品交互的规划方法里,跟加载性能是一体的,3D选装配置器定制开发的排期也按这个顺序走,不是两件事。
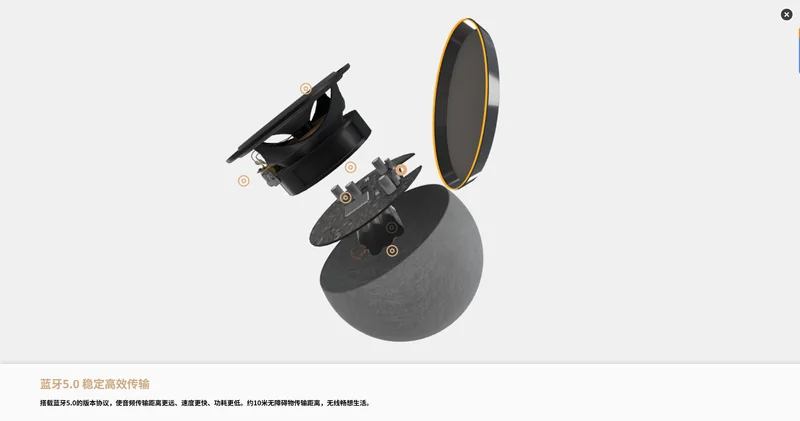
我们给一个蓝牙音箱品牌做 Shopify 3D 展示案例的时候,先定的预算是 1.2MB 总量,建模那边就照着这个预算去规划面数和贴图规格,一次做对,没有返工。
给还在纠结的一句话
电商Web3D展示的价值是真的,客户的停留时长、加购率、退货率都有公开数据支撑,这个不用怀疑。但它有个前提:它得先加载出来。一个八秒才转起来的模型,客户在第二秒就走了,后面所有的交互设计、材质表现、报价联动都无从谈起。
所以这件事的优先级应该往前提,不是等页面做完了再优化,是从提需求的那一刻就把体积预算定下来。
常见问题
手机端做电商Web3D展示,模型体积多少合适?
总量控制在 2MB 以内,中端安卓机三秒内可交互。超过 5MB 就要做 LOD 分级和首帧占位图,否则低端机和弱网环境下转化会明显掉。
一定要用 Draco 压缩吗?会不会有兼容问题?
Draco 是谷歌开源的,主流浏览器和 three.js、model-viewer 都原生支持,兼容性没有问题。唯一要注意的是解码需要加载解码器(约 200KB,可 gzip),所以通常在加载主模型时并行加载。
已经上线的旧模型太大,能直接压吗?
可以,压贴图和几何是纯后处理,不需要重新建模。但如果模型本身建得不规范(内部结构完整、面数过高),压缩后仍然会偏大,那种情况需要重新做一版展示专用模型。
压到 2MB 之后画质会不会明显变差?
不会。被压掉的主要是过剩的贴图分辨率和浮点精度,这两项在手机屏幕上本就是浪费。真正影响观感的是材质参数和光照设置,这两项跟体积无关。